GEO et llms.txt : optimiser son site pour les LLMs en 2026
GEO en 2026 : se faire citer par ChatGPT, Claude, Perplexity ou Google repose sur le contenu, le robots.txt et le suivi. Le llms.txt reste facultatif, et Google l'ignore.
 Par Sébastien
- Publié le
- Mis à jour le
- 17 min de lecture
Au programme 12 sections
- Qu’est-ce que le GEO (Generative Engine Optimization) ?
- En quoi le GEO diffère-t-il du SEO classique ?
- Le fichier llms.txt : proposition initiée par Jeremy Howard en septembre 2024
- robots.txt ou llms.txt : quelle différence ?
- Quelles balises et quels schémas privilégier pour les LLMs ?
- Comment structurer son contenu pour être cité par les LLMs ?
- Mesurer sa visibilité dans les réponses d’IA
- Bloquer ou autoriser les bots IA : choix stratégique
- Cas pratiques : faire citer un article par Perplexity
- Mettre en place le GEO sur un WordPress existant
- Questions fréquentes
- Conclusion
L’essentiel
Pour se faire citer par ChatGPT, Claude, Perplexity, Gemini ou les aperçus IA de Google, le référencement reste la base : Google l’écrit dans son guide sur l’IA générative de mai 2026. Quatre priorités :
- Les bases du référencement : des pages explorables et indexées, un serveur rapide, des données structurées propres (BlogPosting, Organization).
- Un contenu qui répond : une réponse directe sous chaque intertitre, des faits précis et datés, une source pour chaque chiffre. Une étude universitaire de 2023 a mesuré jusqu’à 40 % de visibilité en plus, sur un moteur génératif de test, en ajoutant citations, chiffres et sources.
- Des robots bien réglés : dans le robots.txt, choisissez de refuser ou non les robots d’entraînement des modèles, et laissez passer ceux de recherche des assistants.
- Un suivi régulier : la Search Console et Bing Webmaster Tools mesurent gratuitement votre visibilité dans les réponses d’IA de Google et de Copilot.
Le fichier llms.txt, lui, est facultatif : la recherche Google ne s’en sert pas, et aucun grand service d’IA ne s’est engagé à le lire.
ChatGPT, Claude, Perplexity et les aperçus IA de Google répondent directement aux questions des internautes, en citant quelques sources. Se faire citer dans ces réponses, c’est ce qu’on appelle le GEO, pour Generative Engine Optimization. Le SEO ne disparaît pas pour autant. Dans son guide sur l’IA générative publié le 15 mai 2026, Google l’écrit : de son point de vue, « optimiser la recherche par IA générative revient à optimiser l’expérience de recherche, et donc le SEO ».
Le GEO prolonge donc le référencement naturel. Le même guide range le fichier llms.txt parmi ce que l’on peut ignorer pour la recherche Google (précision du 15 juin 2026, journal des mises à jour). Cet article s’attache à ce qui compte : un contenu qui répond et cite ses sources, des robots bien réglés et un suivi régulier. Le llms.txt y figure aussi, comme une option.
Qu’est-ce que le GEO (Generative Engine Optimization) ?
Le GEO désigne l’ensemble des techniques visant à rendre un contenu visible et citable par les moteurs de recherche génératifs basés sur des LLMs (recherche de ChatGPT, Perplexity, aperçus IA de Google, Claude, Gemini). Le terme a été formalisé en novembre 2023 par une équipe académique réunissant Princeton, Georgia Tech, Allen Institute for AI et IIT Delhi, dans le papier « GEO: Generative Engine Optimization » signé Pranjal Aggarwal et ses co-auteurs. Le travail a ensuite été présenté à la conférence ACM SIGKDD 2024.
L’étude introduit un cadre de mesure (GEO-bench, 10 000 requêtes tirées de neuf sources) et compare plusieurs stratégies d’écriture. Conclusion : ajouter des citations, des statistiques et des sources améliore la visibilité dans les réponses générées, jusqu’à 40 % sur la mesure « Position-Adjusted Word Count » et 28 % sur l’impression subjective. Ces gains ont été mesurés sur un moteur de test, construit sur les cinq premiers résultats de Google : ils montrent une tendance, pas une promesse. Sur Perplexity, le meilleur gain mesuré était de 37 %. Le bourrage de mots-clés, lui, faisait baisser la visibilité.
Le GEO repose donc sur trois leviers : structure éditoriale (réponse directe, H2 questions, listes), fiabilité signalée (citations, sources primaires, chiffres) et accès technique (pages explorables, robots.txt, données structurées).
En quoi le GEO diffère-t-il du SEO classique ?
Le SEO classique vise une place dans une liste de liens. Le GEO vise une citation dans une réponse de quelques phrases. L’objectif change, pas les fondations : chez Google, les réponses d’IA reposent sur les mêmes systèmes de classement et de qualité que la recherche.
Les principaux écarts :
| Critère | SEO classique | GEO |
|---|---|---|
| Objectif | Position dans les résultats | Citation dans une réponse générée |
| Format de sortie | Liste de liens | Paragraphe de synthèse avec ses sources |
| Signal clé | Pertinence et qualité du contenu, liens | Les mêmes, avec des faits clairs et sourcés |
| Outils de suivi | Google Search Console | Rapports IA de la Search Console et de Bing Webmaster Tools, outils payants (Otterly, Profound, AthenaHQ) |
| Métrique | Positions, taux de clic | Part de citations, mentions de marque |
Selon une étude d’Ahrefs (août 2025, 15 000 requêtes), 12 % seulement des liens cités par ChatGPT, Gemini et Copilot figurent dans le top 10 de Google pour la même requête. Pour Perplexity, c’est près d’un sur trois. Pour les aperçus IA de Google, une étude précédente d’Ahrefs comptait 76 % de citations venues du top 10. Un site bien classé sur Google peut donc être absent d’une réponse de ChatGPT, et inversement. Notre guide AI Search Optimization compare ChatGPT, Perplexity et les aperçus IA de Google.
Le GEO ne remplace pas le SEO. Google reste de loin le premier moteur : environ 88 % des recherches en France en septembre 2026, selon StatCounter. Pour bâtir des fondations solides, le guide complet de la création de site WordPress optimisé SEO reste la base, sur laquelle on greffe les optimisations GEO.
Visibilité · SEO
Être trouvé sur Google par les clients qui vous cherchent, là où vous êtes.
Mots-clés locaux, technique irréprochable, contenus utiles et fiche Google Business Profile alignée sur le site.
- Résultat client
- × 14 impressions
- Période
- février → juillet 2026
- Inclus dans
- toutes les formules
Le fichier llms.txt : proposition initiée par Jeremy Howard en septembre 2024
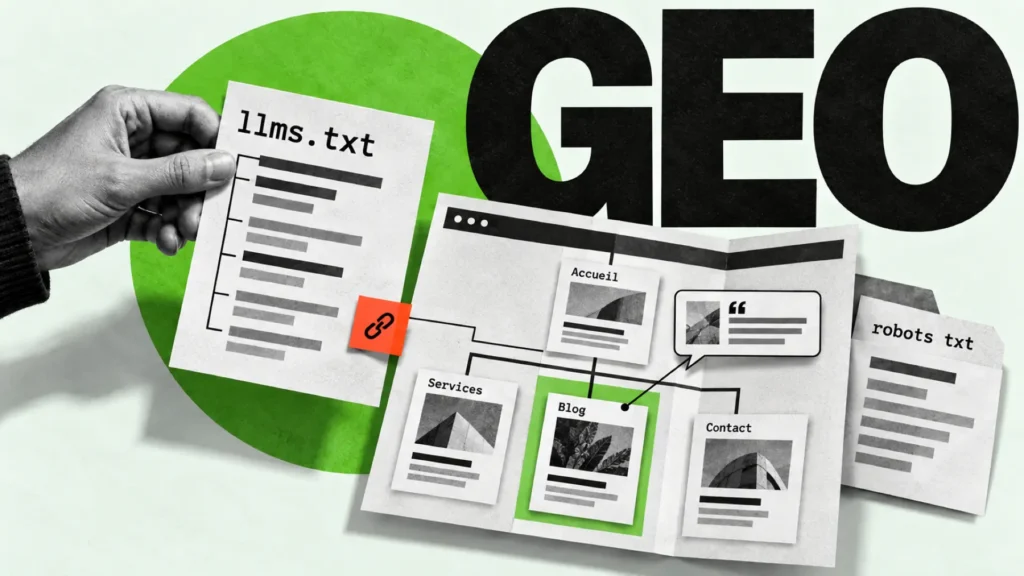
Le fichier /llms.txt est un fichier Markdown, placé en général à la racine d’un site, qui résume son contenu à destination des LLMs. La proposition a été publiée le 3 septembre 2024 par Jeremy Howard sur le blog Answer.AI, avec la spécification officielle hébergée sur llmstxt.org.
Le problème de départ : les fenêtres de contexte des LLMs sont limitées, et le HTML brut d’un site (navigation, JavaScript, publicités) pollue l’extraction du contenu utile. Le llms.txt propose une liste des pages clés, en Markdown, avec une courte description de chacune.
Syntaxe officielle
Le format est strict mais minimal. Un seul élément est obligatoire : un titre H1 avec le nom du site. Le reste suit un ordre fixe : une citation qui résume le site, des informations libres, puis des listes de liens sous des titres H2. Chaque lien s’écrit [Titre](adresse): description, sans espace avant les deux-points. Exemple pour une entreprise imaginaire, à l’adresse example.com :
# Menuiserie Exemple

> Menuiserie artisanale : fenêtres, portes et escaliers en bois, fabriqués et posés sur mesure.

Atelier de quatre personnes. Devis sur rendez-vous.

## Pages principales

- [Nos réalisations](https://example.com/realisations/): fenêtres, portes et escaliers posés chez nos clients.
- [Demander un devis](https://example.com/devis/): formulaire de demande et délais habituels.

## Optional

- [Notre histoire](https://example.com/histoire/): l'atelier et son équipe.
Une section ## Optional reste permise pour les liens secondaires. Depuis la version 2 de la proposition (août 2026), ce n’est plus qu’une convention : elle ne dit plus aux outils quoi laisser de côté.
Versions Markdown, llms-full.txt et adoption
Pour chaque page, la proposition conseille aussi une version Markdown à la même adresse, avec .md ajouté (page.html.md) ou à la place de l’extension (page.md). Certains outils de documentation, comme Mintlify, publient en plus un fichier /llms-full.txt avec le texte complet de la documentation. Ce fichier ne fait pas partie de la proposition.
Anthropic, Stripe, Cursor, Cloudflare, Vercel, Mintlify, Supabase et LangGraph publient un llms.txt pour leur documentation de développeurs. Ailleurs, l’adoption est difficile à chiffrer. Ahrefs en a trouvé un sur 28 % des 137 210 sites suivis par son outil en mai 2026, mais ces sites sont plus techniques que la moyenne : Ahrefs y voit un plafond. Surtout, 97 % de ces fichiers n’ont reçu aucune requête ce mois-là. Aucune norme du W3C ni de l’IETF ne ratifie la proposition. Le fichier coûte peu à créer, et plusieurs extensions WordPress le génèrent.
Le llms.txt ne pèse pas sur le classement Google
Il faut lever une confusion fréquente : le llms.txt n’améliore ni ne dégrade votre référencement Google. Le guide de Google sur l’IA générative, précisé en juin 2026, le dit : ces fichiers n’ont « aucune incidence sur la visibilité ou le classement de votre site dans la recherche Google, car la recherche Google les ignore ». Google peut tomber sur le fichier en explorant le site, mais il ne le traite pas à part. Dès juin 2025, John Mueller (Google) écrivait qu’aucun système d’IA n’utilisait le llms.txt (Search Engine Roundtable) ; en janvier 2026, il ajoutait que sa présence sur des sites de Google n’était pas une approbation. Pour apparaître dans les aperçus IA et le mode IA de Google, aucune optimisation spéciale n’est requise : ce sont les bonnes pratiques du référencement qui comptent.
Le llms.txt sert surtout aux outils qui lisent une documentation technique, comme les assistants de programmation. Dans l’étude d’Ahrefs, les rares lectures venaient d’abord de GPTBot, le robot d’entraînement d’OpenAI, puis de Claude Code, un outil de programmation, avant tout robot de recherche ou d’assistant. Ce n’est pas un levier de référencement : ne le présentez jamais comme une astuce pour « monter sur Google ».
robots.txt ou llms.txt : quelle différence ?
Le robots.txt dit aux robots ce qu’ils peuvent explorer. Le llms.txt propose aux outils d’IA une liste de pages à lire. Le premier sert à tous les sites ; le second est facultatif, et Google l’ignore. Aucun fichier « geo.txt » n’est proposé à ce jour.
Aucun des deux ne bloque quoi que ce soit. La norme du robots.txt, la RFC 9309, le précise : ses règles ne valent pas autorisation d’accès. Ce sont des consignes, que les robots suivent de leur plein gré. Le llms.txt, lui, ne fait que proposer des pages.
| Critère | robots.txt | llms.txt |
|---|---|---|
| Année de création | 1994 (protocole d’exclusion des robots) | Septembre 2024 (proposition) |
| Format | Texte brut, avec des règles | Markdown structuré |
| Destinataires | Robots d’exploration (Googlebot, GPTBot…) | Outils d’IA, surtout ceux qui lisent une documentation |
| Rôle | Consignes d’exploration | Sélection des pages à lire |
| Norme | RFC 9309 (2022) | Aucune, proposition ouverte |
| Respect | Volontaire | Volontaire |
| Emplacement | Racine du site | Racine ou sous-dossier (version 2) |
| Lu par la recherche Google | Oui | Non |
Pour les moteurs, le complément utile du robots.txt reste le sitemap.xml, qui liste les pages à explorer. Le llms.txt, lui, se justifie surtout pour une documentation technique.
Quelles balises et quels schémas privilégier pour les LLMs ?
Les données structurées (en JSON-LD) décrivent le contenu sans ambiguïté. Google le précise dans son guide : elles « ne sont pas une obligation pour la recherche par IA générative et aucun balisage schema.org spécial n’est nécessaire ». Elles restent utiles pour les résultats enrichis. Sur un blog, trois cas reviennent : l’article, l’entreprise et la FAQ.
BlogPosting pour les articles
Sur un article, Google recommande ces propriétés BlogPosting : headline, image, author (avec name et url), datePublished et dateModified. Aucune n’est obligatoire. Donnez l’heure et le fuseau horaire dans les dates, par exemple 2026-05-29T08:00:00+02:00 : sans fuseau, Google prend celui de Googlebot.
FAQPage : plus de résultat enrichi
Google n’affiche plus de résultat enrichi FAQ depuis le 7 mai 2026 (journal des mises à jour de Google). Gardez la FAQ visible : elle sert vos lecteurs. Un balisage FAQPage déjà en place peut rester, mais il est inutile d’en ajouter, pour la recherche classique comme pour les réponses d’IA. Notre guide complet des schémas JSON-LD pour le SEO détaille les autres types.
Organization avec sameAs
Au niveau du site, un balisage Organization (ou LocalBusiness pour une activité locale) qui liste vos profils dans sameAs aide Google à identifier votre entreprise et à la distinguer des autres.
Structure HTML qui parle aux LLMs
Au-delà du balisage, la structure du texte compte. Cinq règles simples :
- H1 unique avec mot-clé principal en début.
- H2 sous forme de questions naturelles.
- Réponse directe en une phrase juste après chaque H2 interrogatif.
- Définitions explicites « X est… » à la première occurrence d’un terme technique.
- Listes à puces et tableaux dès qu’une comparaison ou une énumération s’y prête.
C’est ce qui rend un article clair, pour les lecteurs comme pour les moteurs. Cette logique rejoint les tendances web design 2026 qui valorisent les contenus structurés et la performance.
Comment structurer son contenu pour être cité par les LLMs ?
L’étude GEO met en avant trois leviers d’écriture : les citations, les statistiques et la structure. Ce sont aussi de bonnes pratiques pour le lecteur. Voici la méthode pratique.
Réponse directe en tête de bloc
Après chaque H2 interrogatif, la première phrase doit répondre directement à la question. Pas de mise en bouche. Pas d’effet de manche. C’est aussi ce que le lecteur cherche en premier.
Citations sourcées et statistiques vérifiables
Dans l’étude GEO, ajouter des citations directes et des statistiques chiffrées a augmenté la visibilité de 30 à 40 % dans le moteur de test.
Trois bonnes pratiques :
- Lier chaque chiffre vers sa source primaire (CNIL, INSEE, Eurostat, MDN Web Docs, W3C).
- Préférer les chiffres précis aux approximations (« 67,3 % » plutôt que « environ deux tiers »).
- Dater les données systématiquement (« selon X publié en mars 2026 »).
Densité d’informations et clarté lexicale
Un article dense, aux faits vérifiables, vaut mieux qu’un long texte vague. Google le rappelle dans son guide : « il n’y a pas de longueur de page idéale », et il est inutile d’adapter son style d’écriture à l’IA. Notre guide des 10 astuces pour un site internet réussi rappelle ces principes éditoriaux côté humain.
Erreurs à éviter
- Réponses noyées en fin de paragraphe.
- Affirmations sans source.
- Vocabulaire promotionnel non vérifiable.
- Citations approximatives reformulées sans guillemets.
- Chercher à manipuler les réponses d’IA, par exemple avec une page par variante d’une même question. Depuis le 15 mai 2026, Google le précise : ses règles anti-spam valent aussi pour ses réponses générées.
Mesurer sa visibilité dans les réponses d’IA
Deux outils gratuits mesurent déjà une partie de votre visibilité dans les réponses d’IA. Le rapport sur les performances dans l’IA générative de la Search Console couvre les aperçus IA et le mode IA de Google : lancé le 3 juin 2026, il est ouvert à tous les sites depuis le 31 août 2026. Le rapport AI Performance de Bing Webmaster Tools, en préversion depuis le 10 février 2026, compte les citations de vos pages dans Copilot et dans les résumés d’IA de Bing.
Pour suivre ChatGPT, Perplexity ou Claude, il faut un outil payant, ou des tests à la main. Trois exemples d’outils payants (tarifs relevés en octobre 2026) :
| Outil | Spécialité | Tarif d’entrée |
|---|---|---|
| Otterly.AI | Suivi des mentions et des citations dans ChatGPT, Perplexity, les aperçus IA de Google et Copilot ; Claude, Gemini et le mode IA en option | À partir de 29 $/mois |
| AthenaHQ | Plateforme GEO avec recommandations d’actions | Formule gratuite limitée, puis 295 $/mois |
| Profound | Suivi de visibilité, comparaison avec les concurrents | Essai de 7 jours, puis sur devis |
Pour une PME ou un indépendant, Otterly est le plus abordable ; AthenaHQ et Profound visent plutôt des équipes marketing. Pour démarrer, une vérification manuelle chaque mois sur 10 requêtes types reste largement suffisante. Gardez aussi en tête la mise en garde de Google : « Aucun outil tiers n’a accès à nos systèmes internes de classement ou d’IA. » Méfiez-vous des outils qui promettent un meilleur classement.
Bloquer ou autoriser les bots IA : choix stratégique
Le choix d’autoriser ou de bloquer les bots IA via robots.txt est devenu un sujet stratégique. Bloquer trop large ferme la porte aux citations dans les moteurs IA. Tout autoriser, c’est laisser aspirer vos pages pour entraîner des modèles d’IA.
Cartographie 2026 des bots IA
| Éditeur | Entraînement | Recherche (index) | Visite demandée par l’utilisateur |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Perplexity | — | PerplexityBot | Perplexity-User |
| Google-Extended (marqueur, pas un robot) | Googlebot (aperçus IA et mode IA compris) | — | |
| Apple | Applebot-Extended (marqueur) | Applebot | — |
| Common Crawl | CCBot (archive ouverte du web) | — | — |
La distinction compte. Les robots d’entraînement collectent des pages pour entraîner des modèles. Les robots de recherche indexent les pages à l’avance, pour que l’assistant puisse les citer. Les visites demandées par l’utilisateur ont lieu quand quelqu’un demande à l’assistant de lire une page : OpenAI et Perplexity préviennent qu’elles peuvent ignorer le robots.txt. Enfin, Google-Extended et Applebot-Extended ne sont pas des robots : ce sont des marqueurs, lus dans le robots.txt, pour les usages d’IA de Google et d’Apple.
Une stratégie courante
Une stratégie courante consiste à refuser les robots d’entraînement et à laisser passer les robots de recherche. Exemple de robots.txt pour un site WordPress imaginaire, à l’adresse example.com :
# Entraînement des modèles d'IA : refusé
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Applebot-Extended
User-agent: CCBot
Disallow: /

# Tous les autres robots, dont ceux de recherche
# (OAI-SearchBot, Claude-SearchBot, PerplexityBot) : mêmes règles
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap.xml
Les robots de recherche n’ont pas ici de groupe à part : un robot qui a son propre groupe n’obéit plus au groupe User-agent: *, et pourrait explorer ce que le site interdit à tous. Vos pages restent ainsi ouvertes aux robots de recherche des assistants, mais fermées aux robots d’entraînement de la liste. Vous pouvez aussi refuser Google-Extended : ce marqueur n’a aucun effet sur la recherche Google, mais vos pages ne serviront plus à l’entraînement de Gemini ni aux réponses des applications Gemini.
En France, depuis le 22 juillet 2026, la Search Console permet aussi de décider si votre site apparaît dans les aperçus IA et le mode IA de Google. Selon Google, ce réglage n’est pas un signal de classement pour le reste des résultats.
Le robots.txt ne suffit pas toujours. Cloudflare a documenté en août 2025 des robots non déclarés de Perplexity, qui contournaient ces consignes. La solution radicale passe par un filtrage côté serveur (pare-feu de Cloudflare, extension WordPress de protection). Si votre site passe par Cloudflare, vérifiez aussi ses réglages : le 1er juillet 2025, Cloudflare a choisi de bloquer par défaut les robots d’IA. Depuis le 24 septembre 2025, il propose en outre des signaux de contenu à ajouter au robots.txt (search, ai-input, ai-train), pour dire à quoi vos pages peuvent servir.
Le piège de tout bloquer
Bloquer tous les robots d’IA, c’est sortir de leurs réponses. OpenAI le précise : un site qui refuse OAI-SearchBot n’apparaît plus dans les réponses de la recherche de ChatGPT, sinon comme simple lien de navigation. Si votre activité dépend des visites venues des moteurs, ce choix se paie. À arbitrer selon votre secteur et votre stratégie de marque.
Cas pratiques : faire citer un article par Perplexity
Hypothèse de travail : vous publiez un article sur la création de site WordPress et vous voulez qu’il sorte quand quelqu’un demande à Perplexity « quel CMS choisir pour un site vitrine en 2026 ? ». Voici la recette en cinq étapes.
- Relevé de la requête cible : tapez la question dans Perplexity, lisez les sources citées, notez les domaines récurrents (Reddit, Wikipedia, blogs spécialisés). C’est votre point de comparaison.
- Structure éditoriale : reformulez le H1 en question naturelle, ajoutez une réponse directe en 30 mots juste après, insérez 3 à 5 statistiques chiffrées sourcées.
- Signaux d’autorité : citez 2 ou 3 experts ou études, entre guillemets, avec un lien vers la source. Des articles d’autres sites qui parlent de vous comptent aussi, s’ils sont spontanés.
- Exposition technique : vérifiez que
PerplexityBotest autorisé dans le robots.txt et validez le balisageBlogPostingavec le test des résultats enrichis de Google. - Suivi : refaites la recherche chaque semaine pendant un mois. Si l’article n’apparaît pas, revoyez d’abord son contenu : réponse directe, faits précis, sources.
C’est aussi le travail d’une refonte de site internet orientée GEO et SEO.
Mettre en place le GEO sur un WordPress existant
Pour un site WordPress déjà publié, voici un plan en six étapes :
- Relecture éditoriale : repérer les 20 articles à plus fort potentiel, vérifier la réponse directe sous chaque H2.
- Données structurées : vérifier le balisage
BlogPostingetOrganization, avec l’heure et le fuseau horaire dans les dates. - llms.txt, si vous le souhaitez : le créer à la main ou avec une extension SEO. Il reste facultatif.
- robots.txt : refuser ou non les robots d’entraînement, laisser passer les robots de recherche, comme décrit plus haut.
- Citations et chiffres : enrichir chaque article phare avec 3 à 5 statistiques sourcées et 2 à 3 citations directes.
- Suivi : rapports de la Search Console et de Bing Webmaster Tools, puis un abonnement Otterly ou une vérification manuelle chaque mois sur 10 requêtes types.
La performance technique reste un prérequis. Pour les robots, c’est la réponse du serveur qui compte : Google explore moins un site dont le serveur ralentit ou renvoie des erreurs. Pour les visiteurs, la vitesse se mesure avec les Core Web Vitals (LCP, CLS, INP).
Le SEO local reste indispensable : un commerce ou un cabinet libéral se fait trouver par sa fiche Google et par les recherches locales, comme détaillé dans notre guide SEO local. Le GEO vient en complément, sur les requêtes informationnelles et comparatives.
Questions fréquentes
llms.txt est-il un standard officiel ?
Non. La proposition a été publiée le 3 septembre 2024 par Jeremy Howard (Answer.AI), avec la spécification hébergée sur llmstxt.org. Aucune ratification W3C ou IETF n’existe à ce jour. L’adoption reste volontaire. Anthropic, Stripe, Cursor, Cloudflare, Vercel, Mintlify, Supabase et LangGraph en publient un pour leur documentation. Le coût est faible, mais rien ne garantit qu’un outil d’IA le lise.
Faut-il bloquer GPTBot pour protéger son contenu ?
Cela dépend de votre modèle économique. Bloquer GPTBot, le robot d’entraînement d’OpenAI, refuse vos pages à l’entraînement de ses modèles, mais n’empêche pas d’apparaître dans la recherche de ChatGPT, qui passe par OAI-SearchBot. Une stratégie courante consiste à refuser les robots d’entraînement (GPTBot, ClaudeBot, CCBot) et à laisser passer les robots de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot).
Comment savoir si Perplexity cite mon site ?
Le moyen le plus simple est de poser manuellement vos requêtes cibles dans Perplexity et de lire les sources citées en bas de réponse. Pour automatiser, des outils comme Otterly (à partir de 29 $/mois), AthenaHQ ou Profound suivent vos mentions dans les principaux assistants d’IA, selon la formule choisie.
GEO vs SEO : faut-il choisir ?
Non. Le SEO classique reste indispensable, parce que Google traite encore l’immense majorité des recherches (environ 88 % en France, selon StatCounter). Le GEO est complémentaire : selon Ahrefs (août 2025), 12 % seulement des liens cités par ChatGPT, Gemini et Copilot figurent dans le top 10 de Google. Un site sérieux travaille les deux : SEO pour les requêtes transactionnelles et locales, GEO pour les questions d’information et de comparaison.
Mon WordPress doit-il avoir un llms.txt ?
Ce n’est pas nécessaire : la recherche Google l’ignore, et les grands assistants d’IA ne disent pas le lire. Le fichier se crée vite, à la main ou avec une extension comme Yoast SEO ou AIOSEO. Il sert surtout aux outils qui lisent une documentation technique. Pour un site vitrine de quelques pages, l’intérêt est faible.
Les schémas JSON-LD aident-ils vraiment les LLMs ?
En partie. Pour Google, aucun balisage spécial n’est nécessaire pour apparaître dans ses réponses d’IA. Le balisage reste utile pour les résultats enrichis, par exemple BlogPosting pour un article et Organization pour l’entreprise. La FAQ, elle, n’a plus de résultat enrichi depuis mai 2026.
Conclusion
Se faire citer par les IA repose d’abord sur un bon référencement. La méthode tient en quatre gestes : structurer chaque article avec une réponse directe et des sources vérifiables, soigner les bases techniques et les données structurées, choisir quels robots d’IA autoriser dans le robots.txt, et suivre sa visibilité dans la Search Console et Bing Webmaster Tools. Le llms.txt reste facultatif.
Vous avez déjà un site ? Demandez notre diagnostic gratuit, avec un compte rendu écrit sous 5 jours ouvrés. Pour un site neuf ou une refonte, la formule Pro de Wasabi Web Design comprend une optimisation SEO avancée : recherche des mots-clés, données structurées, une page par service, suivi Search Console.
Partager LinkedIn(nouvel onglet) E-mail
Je conçois des sites rapides et bien référencés pour les indépendants, les professions libérales et les PME, et je partage ici ce que j’apprends sur le terrain.